
商傳媒|何映辰/台北報導
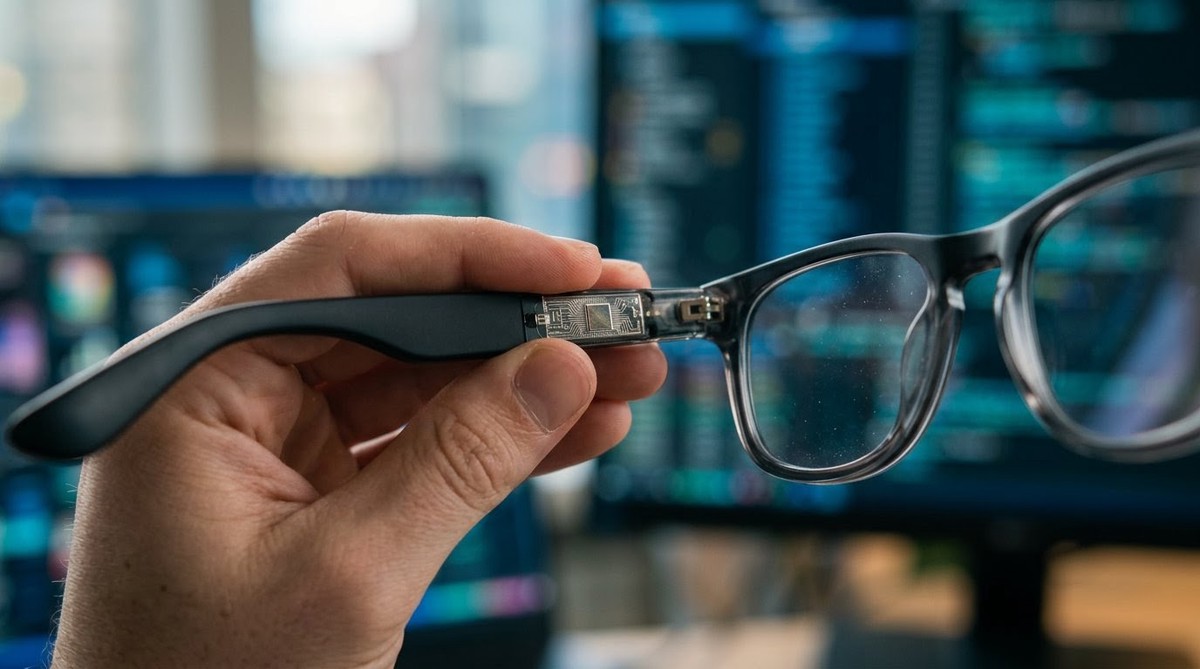
以發行美元穩定幣 USDT 聞名的 Tether,其人工智慧研究團隊 Tether AI Research 昨日宣布推出一款名為 QVAC TranscribePsy 的語音辨識模型。這款模型最大的特色在於其「裝置端(on-device)」運作能力,意即能夠直接在智慧型手機、智慧眼鏡以及人形機器人等裝置上進行語音處理,而無需將用戶的語音資料上傳至雲端伺服器。
QVAC TranscribePsy 是一個輕量級的多語言自動語音辨識(ASR)模型,擁有 2.54 億個參數。它能在裝置上以近乎即時的速度處理音訊,例如透過藍牙或 Wi-Fi 連接到智慧眼鏡,或直接在人形機器人的板載處理器上執行。這種本地化處理的方式,能夠有效提升用戶資料的隱私保護,避免個人生活中敏感資訊(如醫療諮詢、法律訪談、治療會談或機密新聞採訪)因上傳雲端而外洩。
在效能方面,根據《Tether.io》報導,QVAC TranscribePsy 在多項基準測試中表現優異。在 Open ASR Leaderboard 上,其字詞錯誤率(WER,一種衡量語音辨識準確度的指標)為 8.02%;在 Multilingual LibriSpeech 數據集上達到 6.58%,於 Common Voice 數據集上則為 21.56%。Tether 指出,該模型在 2.54 億參數級別的模型中,表現超越了包含 Qwen3-ASR-0.6B、omniASR-CTC-1B-v2 和 Whisper-Medium 等體積大 3 到 4 倍的競爭模型。
此外,QVAC TranscribePsy 在手機上的運行速度也相當突出。在六款智慧型手機的測試中,其運行速度比次快的模型快 2.6 倍,比 Whisper-small 快 5.7 倍。例如,在 iPhone 17 Pro Max 上,其 Core ML 版本僅需 1.65 秒即可轉錄 10 分鐘的音訊,同時使用的磁碟空間不到一半,記憶體也較競爭產品少 1.7 倍。該模型支援筆記型電腦上的 25 種歐洲語言,以及手機上的 8 種歐洲語言,並針對 iPhone Neural Engine 提供專用版本。
Tether 執行長保羅·阿爾多伊諾(Paolo Ardoino)表示,人工智慧的未來不應意味著將個人生活資訊暴露給中心化平台。他強調,先進的語音 AI 應能快速、高效且完全在本地運作,讓 AI 成為手機、眼鏡和機器人的一部分,而資料仍由用戶掌握,隱私得以保障。QVAC TranscribePsy 已根據 Apache授權條款2.0版 發布,供研究和教育目的使用。

與此同時,人工智慧公司 xAI 也於昨日宣布推出 Grok Voice 3.0,這款語音轉語音模型主要用於客服應用,已在特斯拉(Tesla)車輛和星鏈(Starlink)客服中心處理數百萬次對話,展現出低延遲和高效能的特點。這些技術進步共同描繪了 AI 在語音互動領域的未來,有望為用戶帶來更智慧、更私密的裝置使用體驗。