
商傳媒|葉安庭/綜合外電報導
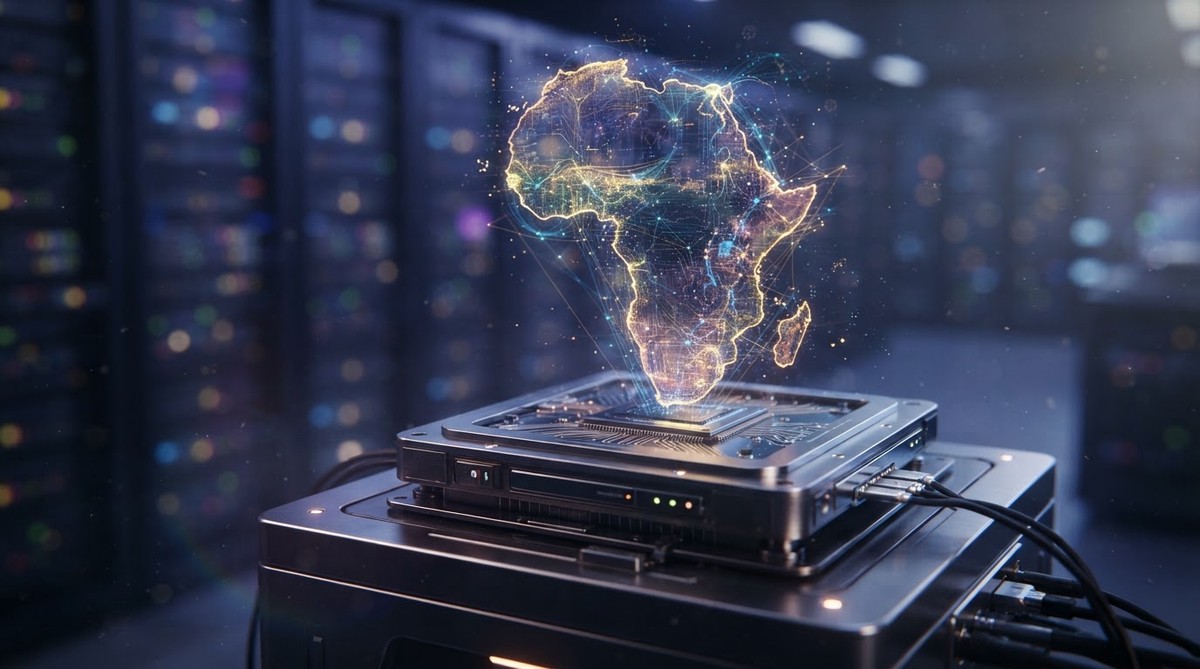
非洲人工智慧公司Vambo AI開發的語言模型MORENA,近期在非洲語言處理領域展現卓越能力,不僅涵蓋12種非洲語言,更在特定基準測試中超越Google、Meta Platforms、阿里巴巴和Hugging Face等科技巨頭的模型,同時體積僅為競爭對手的八分之一。這項發展證明,新興市場也能發展出高效且具競爭力的AI技術。
根據《TechRadar》報導,這款擁有15億參數的MORENA模型,在評估語言模型壓縮資料效率的關鍵指標「bpb」(bits per byte,數值越低代表模型對語言的理解與預測能力越好)測試中,獲得1.408 bpb的成績,領先其他25個受測模型。相較於其他大型競爭對手,MORENA處理非洲文字所需的Token(標記,AI處理語言的最小單位)更少,例如比Gemma 3少1.39倍,比Llama 3.2少1.53倍,大幅提升效率。
MORENA的卓越性能也體現在其資源消耗上。開發人員指出,一個120億參數的Gemma系統運算量約是MORENA的11倍,但在相同文本上的表現卻較弱。即便與同樣針對非洲語言優化的Lugha-Llama-8B模型相比,MORENA在12種語言中有8種表現更佳,且其經對話調校(instruct-tuned)的版本僅使用Lugha-Llama-8B約五分之一的參數,卻能在五種共同語言中領先。
此外,MORENA的開發成本相對親民,約需2.2萬小時的A100 GPU運算時間,估計電腦資源成本約4萬美元。該專案也推出0.5億及0.2億參數的輕量級版本,其中0.5億版本在11種非洲語言測試中超越所有外部系統。0.2億參數的納米版本專為語音辨識、鍵盤應用和文本正規化等任務設計,每個位元組的處理成本比Lugha-Llama-8B低58倍,並且在單一A100 GPU上每秒能產生104個Token。甚至還有能離線運行於筆記型電腦的CPU相容版本,適合GPU資源不穩定的地區使用。
非洲AI模型的崛起,不只代表技術發展的全球普及,也可能為台灣科技產業在新興市場的佈局,提供借鏡與新的合作可能性。


〈非洲本土AI模型MORENA問世 擊敗科技巨頭展現成本效益〉這篇文章最早發佈於《新觀點》。